
Vom gelesenen Code zur richtigen Zuordnung
Data-Matrix-Code: Aufbau, Unterschied zum QR-Code und Einsatz im Betrieb
Ein Data-Matrix-Code speichert Daten in einem zweidimensionalen Muster aus hellen und dunklen Modulen. Er lässt sich beispielsweise auf einem Etikett drucken oder direkt auf einem Bauteil markieren. Ein geeignetes Lesegerät erfasst das Muster und decodiert seinen Inhalt. Ob die gelesenen Daten zum erwarteten Material und zum aktuellen Arbeitsschritt passen, ist eine zusätzliche Frage der Anwendung.[1][2]
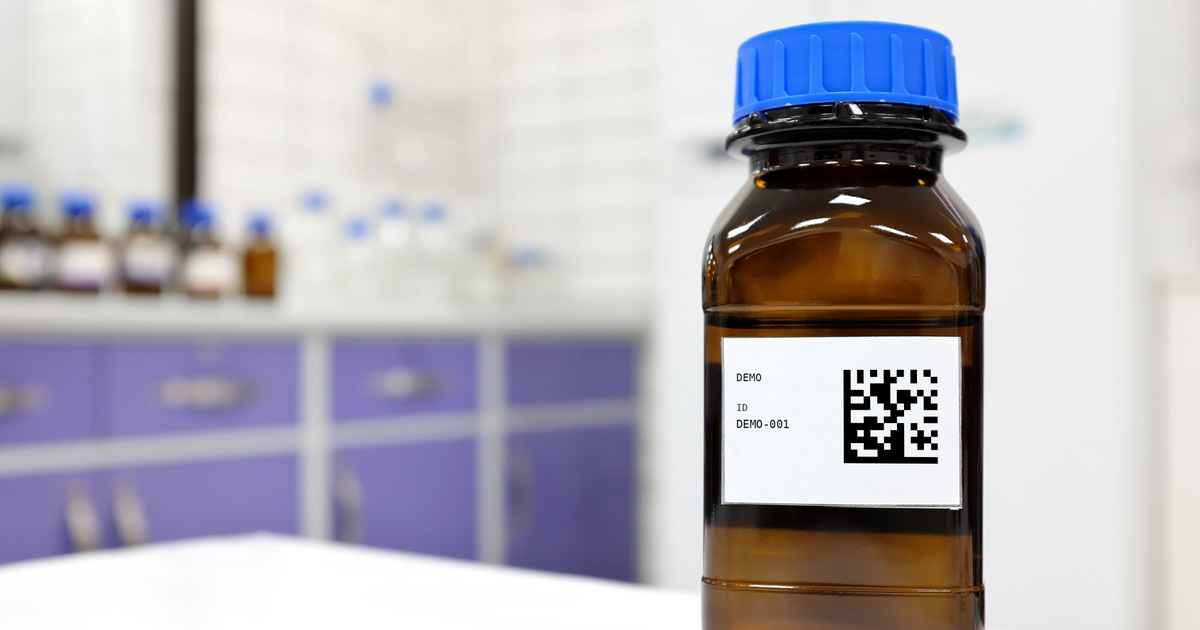
Was ist ein Data-Matrix-Code?
Data Matrix ist eine Codeart, mit der Daten auf einer quadratischen oder rechteckigen Fläche dargestellt werden. Anders als bei einem linearen Strichcode nutzt die Anordnung beide Dimensionen. Die Variante ECC200 verwendet eine Fehlerkorrektur nach Reed-Solomon, die bestimmte Fehler in den erfassten Daten ausgleichen kann.[2]
Ein solcher Code kann eine betriebsinterne Kennung tragen. Beim GS1 DataMatrix folgen die enthaltenen Daten dagegen den Regeln des GS1-Systems. Deshalb lässt sich aus dem Aussehen allein noch nicht ableiten, ob der Inhalt eine Materialnummer, eine Charge oder ein einzelnes Exemplar bezeichnet. Dafür muss die Anwendung den Inhalt und seine Struktur auswerten.[1][2]
Aufbau und Größe
Ein L-förmiges, durchgehend dunkles Suchmuster hilft dem Leser, das Symbol zu lokalisieren und seine Orientierung zu bestimmen. An den gegenüberliegenden Seiten wechseln helle und dunkle Module. Innerhalb dieser Begrenzung liegt der codierte Datenbereich. Bei GS1 DataMatrix muss außerdem auf jeder Seite eine freie Ruhezone von einem Modul Breite bestehen.[1][2]
Bei der Größenfrage sind zwei Dinge zu unterscheiden: die Anzahl der Module und ihre physische Größe. Wie viele Module benötigt werden, hängt von den zu codierenden Daten und ihrer Codierung ab. Die Modulgröße, auch X-Dimension genannt, richtet sich bei GS1-Anwendungen nach der jeweiligen Anwendungsvorgabe. Eine allgemein gültige Mindestgröße in Millimetern wäre deshalb irreführend.[1][2]
Das hat eine praktische Konsequenz: Zusätzliche Daten können mehr Module erfordern. Werden diese auf dieselbe verfügbare Fläche gedrängt, werden die einzelnen Module kleiner. Bei der Planung müssen deshalb Datenumfang, Kennzeichnungsfläche, Herstellungsverfahren und Lesebedingungen zusammenpassen. Die Ruhezone gehört zum benötigten Platz.[1][2]
Fehlerkorrektur ist dabei keine Garantie für beliebige Beschädigungen. Die GS1-Spezifikation beschreibt die Korrekturmöglichkeiten je Symbolgröße anhand von Codewörtern. Daraus lässt sich keine allgemeine Zusage ableiten, ein festgelegter Prozentsatz der sichtbaren Codefläche dürfe fehlen.[2]
Data Matrix und QR-Code im Vergleich
Beide gehören zu den zweidimensionalen Codes. Ein QR-Code ist jedoch keine Unterart von Data Matrix. Unterschiede betreffen unter anderem das Suchmuster und die Fehlerkorrektur. Für den Einsatz zählt außerdem, welche Datenstruktur und welche Lesegeräte die Anwendung unterstützt.[2][4]
| Merkmal | Data Matrix ECC200 / GS1 DataMatrix | QR-Code in der hier betrachteten Standardform |
|---|---|---|
| Suchmuster | L-förmige Begrenzung, ergänzt durch wechselnde Module | Auffällige Suchmuster an drei Ecken |
| Fehlerkorrektur | Fester Umfang je Symbolgröße | Vier wählbare Fehlerkorrekturstufen |
| GS1-Anwendung | GS1 DataMatrix nutzt GS1-Elementstrings; Data Matrix mit Digital Link ist davon zu unterscheiden | QR-Code kann GS1 Digital Link in URI-Form tragen; daneben existiert GS1 QR Code mit eigener GS1-Datenstruktur |
Für einen Betrieb beginnt die Auswahl daher mit der Anwendung: Welche Informationen müssen gelesen werden? Welche Datenstruktur erwartet das Zielsystem? Welche Kennzeichnung ist auf dem Objekt möglich und unter den tatsächlichen Bedingungen lesbar? Eine pauschale Rangfolge der beiden Codearten beantwortet diese Fragen nicht.
Was GS1 DataMatrix ergänzt
GS1 DataMatrix verbindet die Codeart mit einer standardisierten Datenstruktur. Application Identifiers, kurz AIs, geben an, welche Bedeutung die folgenden Daten haben. So steht AI 01 für die GTIN, AI 10 für eine Chargen- oder Losnummer und AI 21 für eine Seriennummer.[1][2]
Das Steuerzeichen FNC1 an erster Position kennzeichnet die GS1-Verwendung. Bei bestimmten aufeinanderfolgenden Datenfeldern sind zusätzlich Trennzeichen erforderlich. Die Klammern, mit denen AIs in der Klarschrift dargestellt werden, gehören dagegen nicht zu den codierten Daten. Diese Regeln helfen der Software, die Felder richtig auszuwerten; sie belegen keine Echtheit des gekennzeichneten Objekts.[1][2]
GS1 DataMatrix und Data Matrix mit GS1 Digital Link sind ebenfalls zu unterscheiden. Ersterer verwendet GS1-Elementstrings. Digital Link stellt Identifikationsdaten in einer webkompatiblen URI-Struktur dar, die sowohl in einem Data-Matrix- als auch in einem QR-Code enthalten sein kann. Welche Variante verarbeitet werden kann, muss zur Anwendung passen.[4]
Lesen, auswerten und Qualität prüfen
GS1 unterscheidet beim Scannen die Aufnahme des Symbols und die Decodierung des aufgenommenen Bildes. Die gewonnenen Daten werden anschließend zur weiteren Verarbeitung an ein Informationssystem übergeben. Für GS1 DataMatrix kommen bildbasierte Leser oder entsprechende Kamerasysteme zum Einsatz.[1][2]
Die Symbolverifikation erfüllt eine andere Aufgabe: Sie bewertet die Qualität des Symbols nach festgelegten Kriterien. Ein erfolgreicher Scan und ein Verifikationsergebnis sind daher unterschiedliche Aussagen. In ihren Hinweisen zur Interpretation von Verifikationsergebnissen stellen die GS1 General Specifications ausdrücklich klar, dass die Richtigkeit des Dateninhalts ohne zusätzliche Software mit Datenbankanbindung nicht bestätigt werden kann. Eine solche Anbindung allein garantiert die Richtigkeit allerdings ebenfalls nicht.[2]
Ebenso muss geprüft werden, ob Klarschrift und Codeinhalt übereinstimmen. Ein fiktives Beispiel: Auf einem Etikett steht Charge CH-50, während der Code CH-56 enthält. Die Prüfung der Symbolqualität allein klärt diesen Widerspruch nicht. Ein Gesamtsystem kann dafür zusätzliche Prüfungen vorsehen; diese sind von der Symbolverifikation zu unterscheiden.[2]
Auch ein bei der Herstellung einwandfreies Symbol kann auf dem weiteren Weg beschädigt werden. Eine Stichprobe bestätigt zudem nicht automatisch die Qualität jedes Symbols einer Produktionscharge. Für den Betrieb folgt daraus: Kennzeichnung und Erfassung sollten unter den tatsächlichen Einsatzbedingungen geprüft werden, einschließlich der Fälle, in denen kein verwertbarer Inhalt gelesen wird.[2]
Vom Scan zum Prozessschritt
Vor der Zuordnung steht die Frage, was die Kennung überhaupt bezeichnet. Bei Handelsartikeln unterscheidet die GTIN die Artikelart; die zusätzliche Chargen- oder Losnummer ordnet sie einer entsprechenden Gruppe zu. Erst GTIN und Seriennummer zusammen identifizieren im hier betrachteten Modell ein einzelnes Exemplar. AI 21 ist daher nicht für sich allein eine weltweit eindeutige Objektkennung.[2]
Zwei Gebinde derselben Artikelart und Charge können denselben codierten Inhalt tragen, wenn keine unterscheidenden Daten hinzukommen. Der Scan dieses Inhalts verrät dann nicht, welches der beiden Gebinde vor dem Leser steht. Wer einzelne Gebinde unterscheiden muss, benötigt eine dafür geeignete Identifikation.[2]
Für die Prozessarchitektur lässt sich daraus eine Prüffolge ableiten: Zuerst wird die Kennung gelesen und ihre Datenstruktur ausgewertet. Danach wird das bezeichnete Objekt oder Los mit dem erwarteten Kontext verglichen. Erst die fachliche Regel legt fest, welche Handlung daraus folgt und welches Ergebnis dokumentiert wird. Diese Prüffolge ist eine architektonische Ableitung, keine allgemeine GS1-Vorschrift.[1][2]
Das Ereignismodell EPCIS macht die Trennung von Identifikation und Kontext anschaulich: Es unterscheidet unter anderem Einzelobjekte und Mengen auf Klassenebene und ergänzt Angaben zu Zeit, Ort und Geschäftsschritt. Dabei bezeichnet eventTime den Zeitpunkt, zu dem das Ereignis laut erfassender Anwendung stattgefunden hat; recordTime betrifft die Erfassung im Repository. Auch diese Zeitangaben sind keine aus dem Code selbst gewonnenen Beweise für die physische Ausführung. EPCIS dient hier als Beispiel für die Ebenentrennung, nicht als Voraussetzung für den Einsatz von Data Matrix.[3]
Wenn die Zuordnung nicht passt
Das folgende Beispiel verwendet ausschließlich fiktive interne Kennungen, keine GS1-Schlüssel. Ein Arbeitsschritt erwartet die Materialart MAT-17. Gelesen wird MAT-19. Der Code wurde erfolgreich decodiert, doch das erkannte Material passt nicht zur Vorgabe. Für diesen Beispielprozess lautet die Regel: Die Materialzuordnung bleibt offen, bis die Abweichung geklärt und die Entscheidung dokumentiert ist. Das ist eine gewählte Prozessregel, keine Funktion, die der Code mitbringt.
Ein zweiter Fall zeigt die Bedeutung der Identifikationstiefe. Zwei Gebinde von MAT-17 gehören zur Charge CH-42. Enthalten ihre Codes nur diese Material- und Chargenkennung, können zwei gleiche Scanergebnisse sowohl zwei Gebinde als auch das zweimalige Lesen desselben Gebindes bedeuten. Aus den Codeinhalten allein lässt sich das nicht entscheiden.
Selbst bei einer eindeutigen Einzelobjektkennung bleibt der Prozesskontext entscheidend: Dasselbe Gebinde kann zuerst im Wareneingang und später bei der Bereitstellung korrekt erneut gelesen werden. Eine Wiederholung am selben Arbeitsschritt kann dagegen eine unbeabsichtigte Doppelbuchung auslösen, wenn jede Erfassung ungeprüft als neuer Vorgang behandelt wird. Die Anwendung braucht deshalb eine Regel, die zur Handlung und zur erwarteten Menge passt; identische Kennungen pauschal zu verwerfen wäre ebenso unzureichend.
Vor der Einführung sollte für jeden Erfassungspunkt feststehen: Welche Ebene wird identifiziert, welcher Zustand wird erwartet und was geschieht bei einem unpassenden oder wiederholten Scan? Erst mit diesen Entscheidungen lässt sich bestimmen, was ein gelesener Data-Matrix-Code im konkreten Arbeitsablauf auslösen darf.